전체 글 49

[1] Apache Spark 살펴보기

1. Spark 주요 설계 철학1. 속도: 중간 결과를 메모리에 유지하여 속도가 빠름2. 사용 편리성: 추상화, 단순성3. 모듈성: 특정 워크로드 처리하기 위해 하나의 통합된 처리 엔진을 가짐4. 확장성: 빠른 병렬 연산, 수많은 데이터 소스로부터 데이터 읽기 가능, 여러 파일 포맷 호환 2. 로컬 스파크 구축1. Java 설치 https://www.oracle.com/kr/java/technologies/downloads/#java11 2. Python 설치 https://www.python.org/downloads/windows/3. PyCharm 설치 https://www.python.org/downloads/windows/ 4. Pyspark 설치: PyCharm New Project -> Ter..
카테고리 없음 2026.11.11

데이터 처리 주요 아키텍쳐, 실시간 데이터 처리

ETL data pipeline- Extract- Transform- Load 데이터처리 주요 아키텍쳐 1) Incremental(증분) 방식: row 수가 작을땐 간단하고 좋음, 확장성 면에서 좋지 않음- 트래픽 문제 해결: 조회 이벤트가 발생할때 큐에 추가. 데이터 손실되지 않는다는 장점. 병목현상 있을 수 있음- Row 수 증가 문제: RDBMS 확장 (수직확장-CPU, Memory, SSD, 수평확장-샤딩:여러개의 DB서버) 2) Lambda architecture- Batch Layer: 주기적 미리 계산된 view (group by 연산 미리 수행 -> 부하 감소)- Speed Layer: 배치 레이어가 커버하지 못하는 최신데이터 view, 복잡성 담당- Serving Layer: 데이터 반환..

데이터 직무

데이터 분석가 : 문제 해결을 위한 KPI 설계, 인사이트, 대시보드 제공, 데이터 의사결정을 도와줌사이언티스트 : 프로덕트 디벨롭하고 만드는데 활용엔지니어 : 데이터 수집을 위한 데이터 파이프라인 개발, 유지보수 1. 기술 역량 (SQL, 대시보드 툴, 파이썬)2. 프로젝트 경험 : 문제 정의 -> 가설 설정 -> 데이터 분석 -> 결과 (2~3개면 충분, 중요한건 분석을 통한 문제해결)3. 포트폴리오 (원인 분석, 제안, 결과 예상, 분석 결과정리 핵심) 산업군 선택 -> 도메인 맞춤 전략 프로젝트 쌓기

🍀/ETC 2026.10.29

파이썬 입력 받기 (sys.stdin.readline)

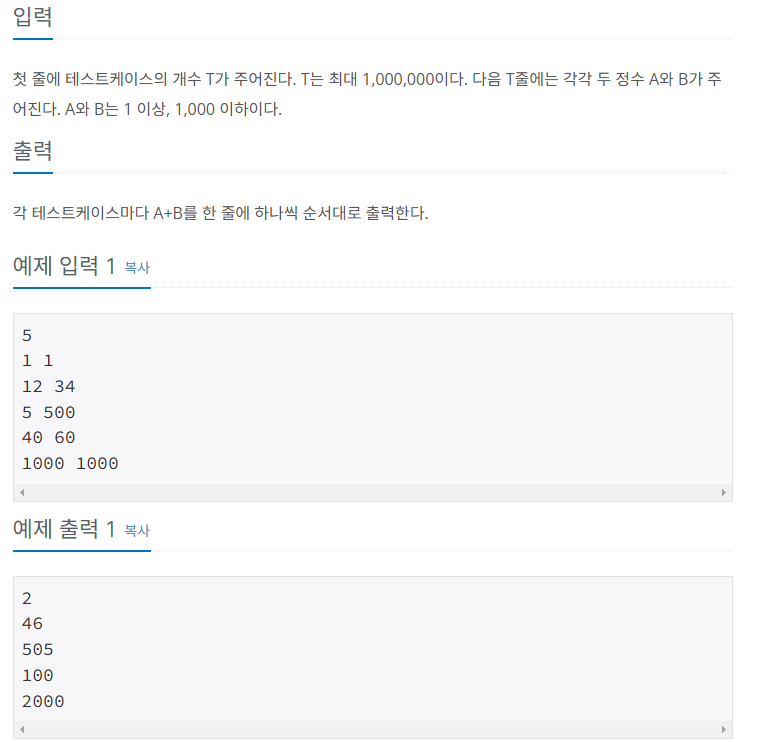
백준 15552번 : 빠른 A+B 알고리즘 문제를 풀 때, 사용자의 입력을 받기 위해 input() 과 sys.stdin.readline() 을 사용한다.이 때, 반복문으로 여러줄을 입력 받아야 할 때 input() 으로 입력 받으면 시간초과가 발생할 수 있다. 시간초과가 나타나는 input() 코드num = int(input())for i in range(num): a, b = map(int, input().split()) print(a+b) sys.stdin 코드import sysinput = sys.stdin.readline()num = int(input())for i in range(num): a, b = map(int, input().split()) print(a+b) 1...

Python/독학 2025.01.26

k3s

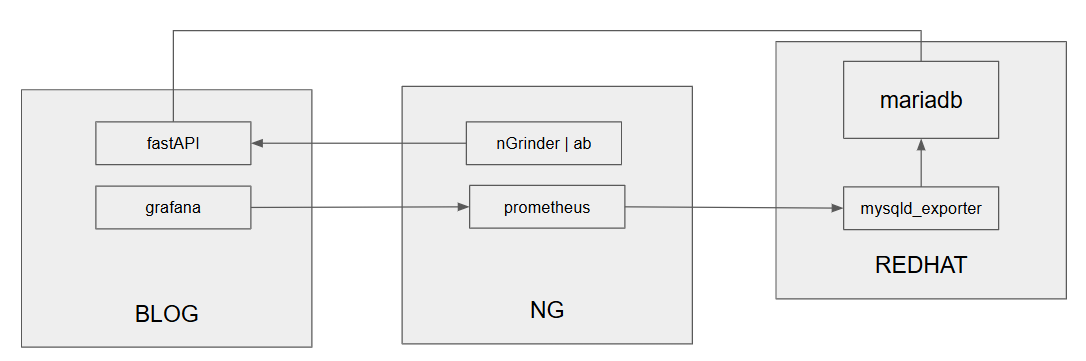
ngrinder (server) / blog (agent)1. 서버에 kube installcurl -sfL https://get.k3s.io | sh - sudo k3s kubectl get node  2. 서버에서 token url 조회sudo cat /var/lib/rancher/k3s/server/node-tokensudo kubectl get node 3. Agent에서 run agentcurl -sfL https://get.k3s.io | K3S_URL=https://:6443 K3S_TOKEN= sh - +) 혹시 안될때 uninstall 실행 후 재실행하기/usr/local/bin/k3s-agent-uninstall.sh 4. 서버에서 잘 띄워졌는지 확인sudo kubectl get nod..

[SPARK] json형식 pyspark 에서 파싱하기

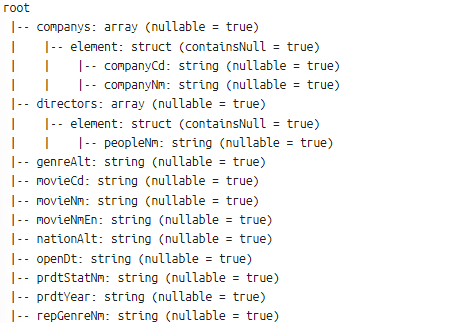
1. JSON 파일 불러오기%spark.pysparkimport osinput_path = os.path.expanduser('~/data/movbotdata/movieList.json')jdf = spark.read.option("multiline", "true").json(input_path)#jdf = spark.read.option("multiline","true").json('/home/odsummer/data/movbotdata/movieList.json') json파일 안에 데이터 형식 단일이 아닌 여러줄로 구성되어 있는 경우, multiline 값을 true로 주는 옵션을 줘야한다.2. JSON 파일 스키마 확인%spark.pysparkjdf.printSchema()root |-- comp..

플레이데이터 데이터 엔지니어링 32기 8월 3주차 회고록

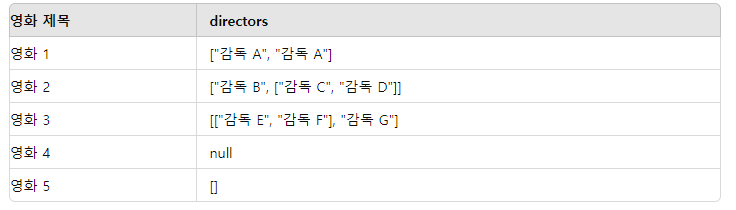
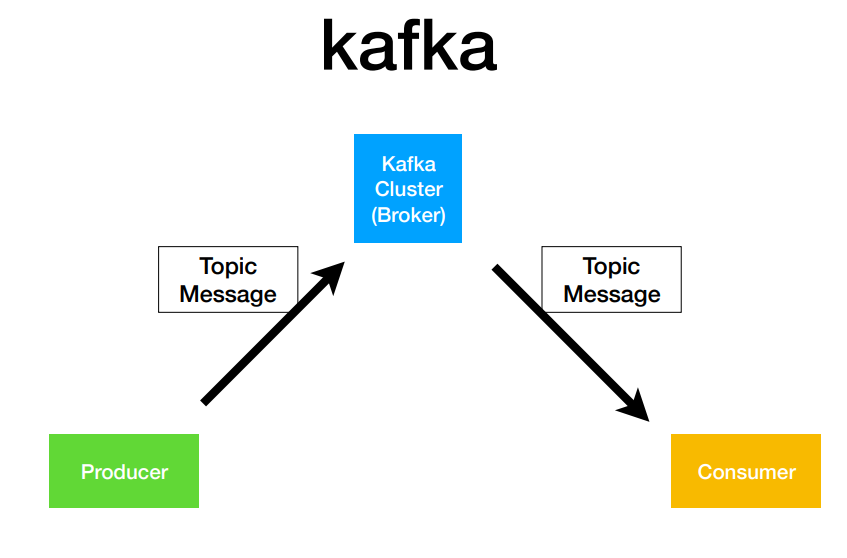
FACTSdynamic jsonline notifykafka https://oddsummer.tistory.com/50 8월 3주차 (8/19~8/23)0819dynamic json 자습^^.. (0820에서 이어짐)08201. git merge 충돌해결1) git push 실행 Updates were rejected because the remote contains work that you do not have locally 에러. 즉 git pull 하라는 뜻2) git pull 실행merge strategy 설정oddsummer.tistory.com 1. dynamic json 실습https://oddsummer.tistory.com/49 movies-dynamic-jsonGITHUBhttps://..

8월 3주차 (8/19~8/23)

0819dynamic json 자습^^.. (0820에서 이어짐)08201. git merge 충돌해결1) git push 실행 Updates were rejected because the remote contains work that you do not have locally 에러. 즉 git pull 하라는 뜻2) git pull 실행merge strategy 설정하라고 뜸.  git config pull.rebase false 으로 설정3) 다시 git pull Automatic merge failed; fix conflicts and then commit the result. 병합충돌 해결하라는 에러 뜸 4) 충돌된 파일 열면 이런식으로 표시                 현재 branch의 충돌 ..